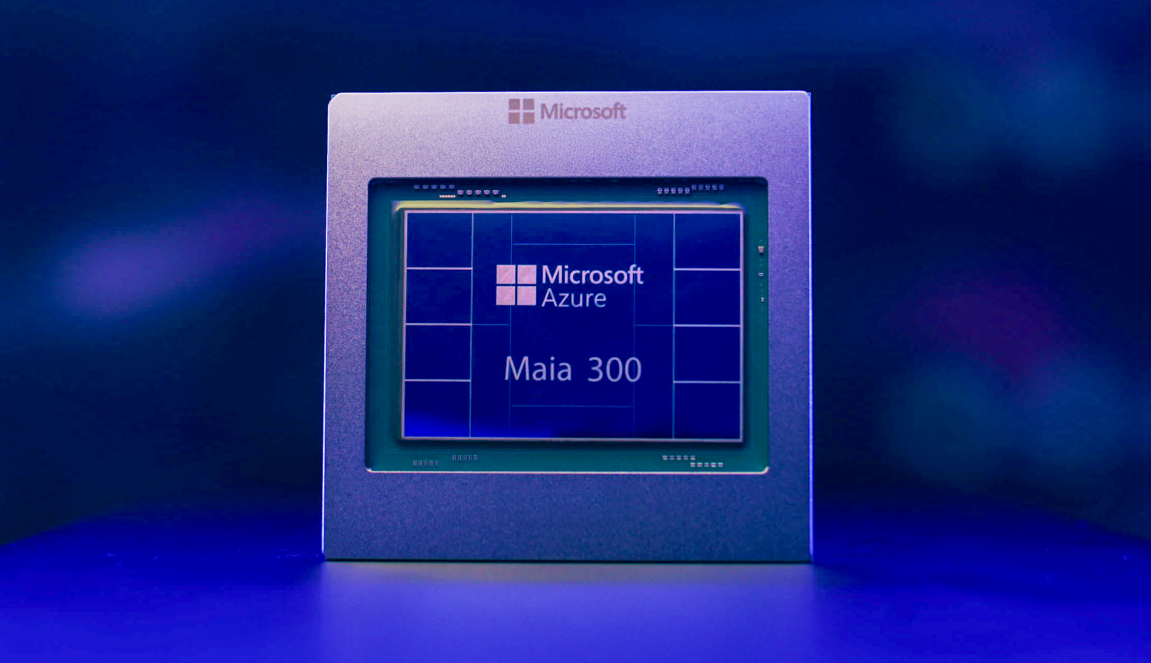
Microsoftは、Azureインフラストラクチャにおける生成AI(特にMicrosoft Copilot等)の推論処理最適化を目的とした、第3世代の自社設計AIアクセラレーター「Maia 300」を発表した。前世代「Maia 200」の発表からわずか約9ヶ月という異例のサイクルで投入される本チップは、肥大化する推論コストと電力消費の抑制、そしてロングコンテキスト処理におけるメモリボトルネックの解消を主眼に設計されている。
本技術の本質的価値は、TSMC 2nm(N2P)プロセスとチップレット構造の採用、次世代メモリ「HBM4」の搭載、そしてラックレベルでの高密度統合(高効率液冷設計を前提とした167kW/ラック)により、電力効率(トークン/W)を極限まで高めた点にある。NVIDIA等の汎用GPUを完全に代替するものではなく、特定の推論ワークロードにおいて「ヘテロジニアスなインフラ構成の最適解」として機能する。
アーキテクチャ・物理構成
Maia 300は、単なるプロセッサー単体のアップデートにとどまらず、シリコン、パッケージング、ラック、ネットワーク、そしてソフトウェアまでを垂直統合したシステムアーキテクチャとして設計されている。
1. シリコン・パッケージング
- プロセスノード: 計算ダイ(Compute Die)にTSMCの最先端2nm世代である「N2P」プロセスを採用。
- パッケージング(チップレット構造): すべての回路を単一の巨大なダイ(モノリシック)で製造するのではなく、最先端プロセスを要する計算ダイと、成熟プロセスで製造可能なメモリコントローラーやI/O機能を分離。これにより、製造歩留まり(Yield)の向上とコスト最適化を両立している。
2. メモリシステム
推論処理、特にLLMのAutoregressive(自己回帰)なデコードフェーズにおける最大のボトルネックである「Memory Bandwidth Bound」を解決するため、メモリスタックを大幅に強化。
- 規格: 次世代超広帯域メモリ「HBM4」を8スタック搭載。
- 容量: 288GB(Maia 200比で33%向上)。
- 帯域幅: 18TB/s(Maia 200比で2.5倍に拡大)。
3. ラックレベル統合(System-on-Rack)
データセンターの物理制約(スペース、給電、冷却)に対して、密度を極限まで高めた設計。
- シャーシ構成: 1ラックあたり24個のトレイを配置し、計96基のMaia 300アクセラレーターを搭載(Maia 200比で密度2倍)。
- ラック総スペック: HBM容量 27.6TB、総メモリ帯域 1.7PB/s。
- 許容電力枠: 167kW/ラック(液冷システムによる熱マネジメントが必須となる超高密度設計)。
4. スケールアウト・ネットワーク(Superpod構成)
- インターコネクト: 128本のラックを光インターコネクト(Optical Interconnect)の第2階層ネットワークでトポロジー接続。
- 最大構成: 単一の「Superpod」内で最大12,288基のアクセラレーターをコヒーレントに統合可能。巨大モデルの分散推論(Tensor Parallelism / Pipeline Parallelism)を低レイテンシで実行する。
技術比較・選定基準
| 評価軸 | Microsoft Maia 300 | NVIDIA H100 / B200 (Hopper/Blackwell) | 既存CPU/汎用アクセラレーター |
|---|---|---|---|
| 主な用途 | 特定AIモデル(Copilot等)の推論特化 | 汎用AI学習(Training)および推論 | 汎用計算、軽量な推論(CPU) |
| メモリ仕様 | HBM4 (288GB, 18TB/s) | HBM3e (141GB~ / 8TB/s~) | DDR5 (数百GB, 100~300GB/s) |
| 電力効率 | 極めて高い(GPU比でMWあたりトークン数+40%見込み) | 高い(ただし汎用アーキテクチャのためオーバーヘッドあり) | 低い(AI処理におけるワットパフォーマンス) |
| エコシステム | Azure内製ソフトウェア(ONNX Runtime, DeepSpeed等に最適化) | CUDAエコシステム(業界標準、極めて高い汎用性) | x86/ARM標準(OpenVINO, ONNX等) |
| 導入・調達コスト | Azureマネージドサービス経由(インフラコスト削減分が価格に還元) | 高価(市場の需給バランスに依存) | 安価〜中程度 |
選定基準(Decision Matrix)
- Maia 300(Azureインスタンス)を選択すべきケース:
- すでにAzure上で大規模なLLM推論パイプラインを運用しており、API呼び出しやホスティングのトークン単価(ランニングコスト)を極限まで下げたい場合。
- 超長文(Long Context)のコンテキストウィンドウを頻繁に処理し、メモリ帯域がボトルネックとなっているワークロード。
- NVIDIA GPUインスタンスを選択すべきケース:
- 独自のカスタムモデルを一から事前学習(Pre-training)または大規模ファインチューニングする場合。
- CUDAに深く依存した独自のネイティブC++拡張モジュールや、マイナーなディープラーニングフレームワークを稼働させる必要がある場合。
メリット / デメリット
メリット(Pros)
- 圧倒的なメモリ帯域によるスループット向上
HBM4による18TB/sの帯域幅は、メモリネックになりやすいLLM推論(特にバッチサイズが大きいマルチユーザー環境)において、トークン生成速度(Tokens per Second)を劇的に向上させる。 - 優れた電力あたりパフォーマンス
ラック全体の最適化により、メガワットあたりのトークン処理量が主要GPUシステム比較で40%向上(Microsoft公表値)。データセンターの電力容量制限下で、より多くの推論リクエストを処理可能。 - 垂直統合によるコスト構造の最適化
シリコンからクラウドサービスまでをMicrosoftが自社で垂直統合することにより、サードパーティ製GPUの調達プレミア(マージン)を排除し、エンドユーザーへの提供価格を抑制できる。
デメリット(Cons)
- ベンダーロックインと環境の不透明性
Maia 300はAzure専用ハードウェアであり、オンプレミスや他社クラウド(AWS, GCP)へのポータビリティはない。 - 汎用性の制限
推論処理および特定のモデルアーキテクチャ(Transformerベース等)に最適化されているため、グラフィックス処理、HPC(高性能計算)、あるいは一部の非標準的なニューラルネットワーク構造においては、汎用GPUほどの柔軟なパフォーマンスを得られない可能性がある。 - 実績値の不足
公表されている「トークン処理量最大7倍(Maia 200比)」や「GPU比40%の効率向上」は、測定条件や比較対象モデルの詳細が非開示であるため、本番環境での実効性能はPoCによる検証を要する。
その他
1. 段階的移行(Phased Migration)の必須性
Microsoft自身も、すべてのCopilotワークロードを即座にMaia 300へ移行するわけではなく、GPUとの併用(ヘテロジニアス運用)を表明している。自社システムでMaiaインスタンスを採用する際も、特定の推論APIエンドポイントから段階的にカナリアリリースを行い、モデルの出力精度やレイテンシのプロファイリングを行う必要がある。
2. コンパイル・最適化パイプラインの適合
Maiaのハードウェア能力を最大化するためには、PyTorchモデルを直接動かすだけでなく、ONNX RuntimeやDeepSpeed、あるいはMicrosoft独自のコンパイラスタックを介した最適化が必須となる。既存のCUDAカーネル(TritonやカスタムCUDAコード)を使用している場合、これらをMaia向けに移植・再コンパイルする工数が発生する。
3. コールドスタートとプロビジョニング
超高密度設計(167kW/ラック)であるため、データセンター側の冷却・給電負荷のローカルな偏りを防ぐため、インスタンスのプロビジョニングやスケーリングの挙動が従来の汎用VMと異なる可能性がある。急激なオートスケーリング時のプロビジョニング遅延(コールドスタート時間)を事前に計測しておくことが推奨される。
コメント