ひろッぴ

TIPS

[AWS]BedrockのRAGとKendra

Amazon BedrockとAmazon Kendraを連携させたRAG構築のメリットと役割分担を解説。Kendraが「検索」、Bedrockが「生成」を担う仕組みや、Knowledge Bases for Bedrockとの違い、選定基準が理解できます。
AI

[AWS]Bedrock KnowledgeBase: インテントルーティング及び実行ルール

Amazon Bedrockを想定した、自然言語クエリからインテントを分類し、APIルーティングと実行ルールを厳格に制御する設計手法を解説。ガードレールやフォールバック処理を組み込み、セキュアで正確な応答を実現するフローが学べます。
AI

[AWS]Bedrock KnowledgeBaseの「正しい」ルール設定

AWS Bedrock KnowledgeBaseのルール設定における「正しい」記述方法を解説。インテントとエンティティの定義、処理フローの明確化、APIルーティング、フォールバック設計など、保守性と拡張性に優れた堅牢なルールファイル作成のポイントが学べます。
AI

[AWS]Bedrock RAGのプロンプトテンプレート

Amazon Bedrock RAGのプロンプトテンプレートで使える3つのプレースホルダーの特徴と使い分けを解説。シンプルな回答生成から、メタデータやスコアを活用した高度な出典付き回答の実現方法まで、RAGの品質を高める技術的知見が得られます。
AI

[AWS]Bedrock Agentsのパフォーマンス・チューニング

Amazon Bedrock Agentsのパフォーマンスを最大化するチューニング手法を体系的に解説。プロンプト調整、APIやRAG(知識ベース)の最適化、基盤モデルの選定からトレース機能を用いたデバッグまで、実践的なアプローチを紹介します。
AI

[AWS]Bedrock RAGのパフォーマンス・チューニング

Amazon Bedrock RAGの精度、応答速度、コストを最適化するチューニング手法を解説。チャンキング戦略や検索結果数の調整、プロンプトエンジニアリング、軽量モデルの選定など、各フェーズにおける具体的な改善策が理解できます。
AI

[AWS]Bedrockで正確な情報出力が必要な場合

AWS Bedrockで正確な情報を出力する際、RAGとAgentのどちらを選ぶべきかの判断基準を解説。情報の出所やタスクの複雑さに応じた選択フローや、両者を組み合わせた堅実な開発アプローチを紹介します。
AI

トークンをカウントする

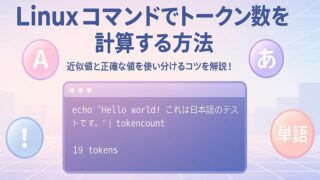
OpenAIのトークン数をカウントする方法を解説。Linux標準コマンド(grep)を用いた手軽な近似値算出から、公式ライブラリ「tiktoken」を使った正確なPython自作コマンドの構築、APIレスポンスからの取得まで、精度と手軽さに応じた3つのアプローチを紹介します。
AI

トークンとは?

生成AIが言語を処理する基本単位「トークン」の仕組みや、英語と日本語における消費量の違いを解説します。APIコストやコンテキストウィンドウの制限に直結するトークン特性を理解し、効率的なプロンプト設計を行うための技術的知見が得られます。
コマンド

wcコマンド

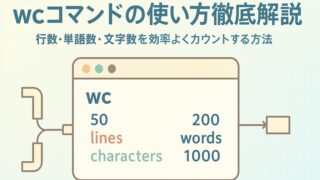
Linuxのwcコマンドの基本から、行数・文字数・バイト数のカウント方法、-cと-mオプションの違いを解説。さらに、lsやgrepなどの他コマンドとパイプで連携し、ファイル数やエラーログ件数を集計する実践的な応用例を紹介します。