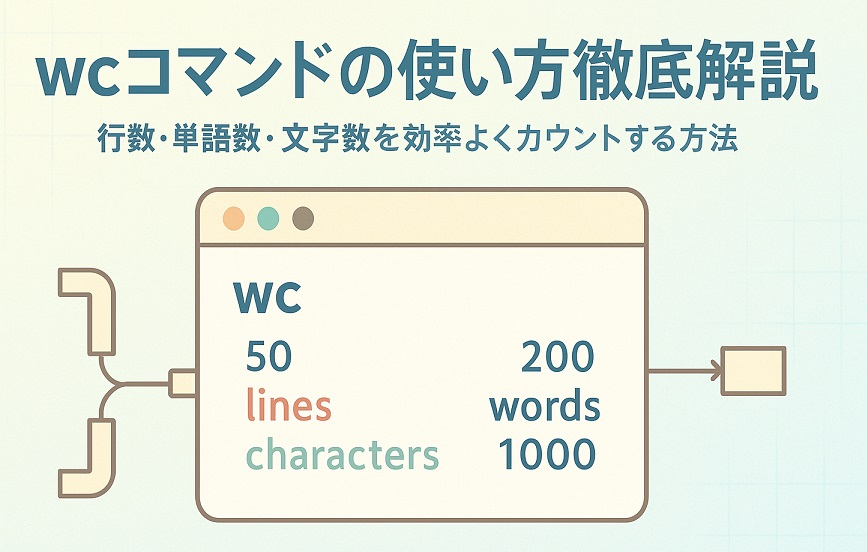
wcは “word count” の略で、テキストファイルや標準入力の行数 (lines)、単語数 (words)、バイト数 (bytes)/文字数 (characters) をカウントするためのLinux/UNIXコマンドです。シンプルな機能ですが、パイプ(|)と組み合わせることで、様々な場面で非常に強力なツールとなります。
基本的な書式
wcコマンドの基本的な使い方は以下の通りです。
- オプションを指定しない場合、
行数単語数バイト数ファイル名の順で表示されます。 - ファイル名を省略するか、ハイフン(
-)を指定すると、標準入力からデータを受け取ります。これはパイプと連携する際に使われます。
wc [オプション] [ファイル名1] [ファイル名2] ...主要なオプション
特定のカウント結果だけを知りたい場合に、以下のオプションを使用します。
| オプション | 説明 |
-l, --lines | 行数 (Lines) のみを表示します。改行文字 \n の数をカウントします。 |
-w, --words | 単語数 (Words) のみを表示します。スペース、タブ、改行などの空白文字で区切られた部分を「単語」としてカウントします。 |
-c, --bytes | バイト数 (Bytes) のみを表示します。ファイルのサイズそのものを知りたい場合に便利です。 |
-m, --chars | 文字数 (Characters) のみを表示します。マルチバイト文字(例:日本語、絵文字)を正しく1文字としてカウントします。 |
-L, --max-line-length | ファイル内で最も長い行の長さ(文字数)を表示します。 |
-c と -m の違い(重要)
wcを使いこなす上で、-c (バイト数) と -m (文字数) の違いを理解することは非常に重要です。
-c(--bytes): ファイルを構成するバイトの総数を数えます。ASCII文字(半角英数字など)は1文字1バイトですが、UTF-8エンコーディングの日本語のようなマルチバイト文字は、1文字が3バイトなどで表現されます。-m(--chars): 文字コード(ロケール設定)を解釈し、文字の数を数えます。日本語1文字も、半角アルファベット1文字も、同様に「1文字」としてカウントします。
具体例
hello.txt というファイルに「hello」とだけ書かれているとします(5文字、改行なし)。
$ wc -c hello.txt
5 hello.txt

$ wc -m hello.txt
5 hello.txt
この場合、ASCII文字だけなのでバイト数と文字数は同じです。
次に、nihongo.txt というファイルに「こんにちは」とだけ書かれているとします(5文字、改行なし)。
# UTF-8の場合、日本語1文字は3バイト
$ wc -c nihongo.txt
15 nihongo.txt  # 5文字 * 3バイト = 15バイト

$ wc -m nihongo.txt
5 nihongo.txt   # 文字数として正しく5文字とカウント
このように、日本語などのマルチバイト文字を扱う場合は -m を使うと意図した通りの文字数が得られます。
実践的な使用例
1. 単一ファイルのカウント
# sample.txt の行数、単語数、バイト数を表示
$ wc sample.txt
 10  55 345 sample.txt

# sample.txt の行数のみ表示
$ wc -l sample.txt
 10 sample.txt

# sample.txt の単語数のみ表示
$ wc -w sample.txt
 55 sample.txt
2. 複数ファイルのカウント
複数のファイルを指定すると、各ファイルの結果と、最後に合計(total)が表示されます。
$ wc file1.txt file2.txt
  5  20 100 file1.txt
 10  45 230 file2.txt
 15  65 330 total
3. パイプ (|) を使った連携
wcの真価は、他のコマンドの出力を受け取って処理する際に発揮されます。パイプでデータを受け取った場合、ファイル名は表示されません。
例1: ディレクトリ内のファイル数を数える
ls -1(1行に1ファイル名ずつ表示)の出力を wc -l に渡すことで、カレントディレクトリ内のアイテム(ファイルとディレクトリ)の総数を数えられます。
$ ls -1 | wc -l
25
例2: ログファイルから特定のエラー行数を数える
grepコマンドで特定の文字列(例: ERROR)を含む行を抽出し、その結果を wc -l に渡すことで、エラーの発生回数をカウントできます。
# access.log ファイルから \"ERROR\" を含む行が何行あるか調べる
$ grep \"ERROR\" access.log | wc -l
152
例3: コマンドのエイリアスの数を数える
aliasコマンドの出力を wc -l に渡して、設定されているエイリアスの数を数えます。
$ alias | wc -l
18
応用テクニック
1. ソートと組み合わせて行数ランキング
wc -l *.log | sort -nr出力例:
   120 error.log
    85 access.log
    30 debug.log
     2 total
2. 単語数の多いファイルトップ5を検出
wc -w * | sort -nr | head -63. 空行を除外した行数カウント
grep -v \'^$\' file.txt | wc -l4. 特定の拡張子の文字数合計
wc -m *.py | awk \'END{print $1}\'5. バイト数と文字数の違いを確認(マルチバイト文字)
echo \"日本語\" | wc -c  # バイト数(UTF-8なら9)
echo \"日本語\" | wc -m  # 文字数(3)
トラブルシューティング
- バイナリファイルの誤処理
   # バイナリファイルをテキストとして処理しない
wc -c binaryfile # バイト数のみ安全- 大量ファイルのメモリ使用
   # 巨大ファイルは分割処理
   split -l 1000000 bigfile.txt part-
wc -l part-*- 改行コードの違い(Windowsファイル)
   # CRLF → LF 変換
   dos2unix windowsfile.txt
   wc -l windowsfile.txt
便利なエイリアス例
.bashrc に追加:
# ファイル統計の詳細表示
alias fstat=\'wc -lwm\'

# ディレクトリ内のソースコード行数集計
alias codesum=\'find . -name \"*.py\" -o -name \"*.js\" | xargs wc -l\'
wc コマンドはシンプルながら、ログ分析やコード統計、システム管理など多様な場面で活用できます。他のコマンドと組み合わせることで、より強力なテキスト処理が可能になります!
まとめ
wcコマンドは、一見地味ですが、Linuxの哲学である「小さなツールをパイプで組み合わせて大きな仕事をする」を体現する、非常に便利で強力なコマンドです。特に -l オプションは、他のコマンドと組み合わせることで、様々な「数を数える」という作業を効率化してくれます。
困ったときは man wc または wc --help で詳細な使い方を確認できます。
コメント