Amazon

AI

[AWS]Bedrock RAGのパフォーマンス・チューニング

Amazon Bedrock RAGの精度、応答速度、コストを最適化するチューニング手法を解説。チャンキング戦略や検索結果数の調整、プロンプトエンジニアリング、軽量モデルの選定など、各フェーズにおける具体的な改善策が理解できます。
AI
[AWS]Bedrockで正確な情報出力が必要な場合

AWS Bedrockで正確な情報を出力する際、RAGとAgentのどちらを選ぶべきかの判断基準を解説。情報の出所やタスクの複雑さに応じた選択フローや、両者を組み合わせた堅実な開発アプローチを紹介します。
ツール

[AWS]Aurora PostgreSQLのチューニングでBedrockの性能を最大化

Amazon BedrockのバックエンドとしてAurora PostgreSQLを使用する際、ベクトル検索やRAGの性能を最大化するパラメータチューニング手法を解説。work_memやHNSWインデックス、並列処理の最適化により、低レイテンシかつ低コストなシステムを実現します。
ツール

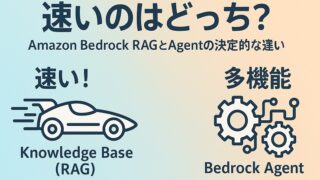
[AWS]レスポンス速度に差が出る理由!BedrockRAGとAgentの決定的な違い

Amazon BedrockのKnowledge Base(RAG)とAgentのレスポンス速度の違いを徹底比較。RAGが高速な理由と、Agentが遅い一方でタスク完了が早い理由をアーキテクチャから解説し、ユースケースに応じた最適な選定基準を提示します。
ツール

[AWS]トークン上限突破!NL-to-SQLの壁を壊すBedrock RAG活用法

Amazon BedrockでのNL-to-SQLにおけるトークン上限問題を解決するため、RAGを活用して必要なテーブル定義のみを動的にプロンプトへ注入する手法を解説。Knowledge BasesやAgentsを用いた具体的なAWS実装パターンが学べます。
TIPS

[AWS]Bedrockエージェントのスキーマ設定

Amazon Bedrockで高精度なSQL自動生成を実現するための、スキーマ定義ファイル(JSON)の作成手順を解説。テーブル構造やメタデータ、制約の記述方法からエラー対策まで、AIエージェントのDB理解を深める実践的ノウハウを紹介します。
ツール

[AWS]OpenSearchのベクターDBが変える検索の未来

AWS OpenSearchのVector DBを効果的に活用するための設定定義(次元数やアルゴリズムなど)や、Amazon Bedrockと連携したRAGソリューション構築に必要なデータ投入・運用プロセスを分かりやすく解説します。
ツール

[AWS]BedrockとOpenSearchで始める、全く新しいベクトルDB入門

Amazon BedrockとOpenSearchを用いたベクトルDBの構築方法を解説。インデックス、マッピング、k-NNアルゴリズムの設定から、検索精度とLLMの応答品質を向上させるメタデータ(スキーマ情報)の効果的な活用法まで網羅しています。
ツール

[AWS]Bedrockで利用可能なLLMモデル一覧

Amazon Bedrockで利用可能な主要LLM(Claude 3、Titan、Llama 3など)の特徴、サイズ、ファインチューニングの可否を一覧で解説。コンソールやAPI(Boto3)を用いたモデルの切り替え手順も網羅しています。
ツール

[AWS]Bedrock ハイパーパラメータ設定

Amazon Bedrockでのモデル微調整におけるハイパーパラメータの推奨値を、NLPや画像認識などのタスク・データ規模別に解説。学習率やEpochsの初期設定から、データ量に応じた調整指針、自動最適化(HPO)の活用まで実践的な知見を紹介します。