AI

[AWS]Bedrockで正確な情報出力が必要な場合

AWS Bedrockで正確な情報を出力する際、RAGとAgentのどちらを選ぶべきかの判断基準を解説。情報の出所やタスクの複雑さに応じた選択フローや、両者を組み合わせた堅実な開発アプローチを紹介します。
AI
トークンをカウントする

OpenAIのトークン数をカウントする方法を解説。Linux標準コマンド(grep)を用いた手軽な近似値算出から、公式ライブラリ「tiktoken」を使った正確なPython自作コマンドの構築、APIレスポンスからの取得まで、精度と手軽さに応じた3つのアプローチを紹介します。
AI

トークンとは?

生成AIが言語を処理する基本単位「トークン」の仕組みや、英語と日本語における消費量の違いを解説します。APIコストやコンテキストウィンドウの制限に直結するトークン特性を理解し、効率的なプロンプト設計を行うための技術的知見が得られます。
コマンド

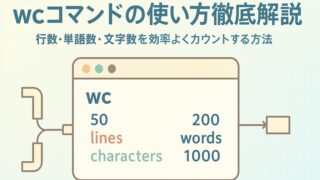
wcコマンド

Linuxのwcコマンドの基本から、行数・文字数・バイト数のカウント方法、-cと-mオプションの違いを解説。さらに、lsやgrepなどの他コマンドとパイプで連携し、ファイル数やエラーログ件数を集計する実践的な応用例を紹介します。
ツール

[AWS]Aurora PostgreSQLのチューニングでBedrockの性能を最大化

Amazon BedrockのバックエンドとしてAurora PostgreSQLを使用する際、ベクトル検索やRAGの性能を最大化するパラメータチューニング手法を解説。work_memやHNSWインデックス、並列処理の最適化により、低レイテンシかつ低コストなシステムを実現します。
ツール

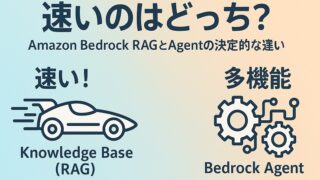
[AWS]レスポンス速度に差が出る理由!BedrockRAGとAgentの決定的な違い

Amazon BedrockのKnowledge Base(RAG)とAgentのレスポンス速度の違いを徹底比較。RAGが高速な理由と、Agentが遅い一方でタスク完了が早い理由をアーキテクチャから解説し、ユースケースに応じた最適な選定基準を提示します。
ツール

[AWS]トークン上限突破!NL-to-SQLの壁を壊すBedrock RAG活用法

Amazon BedrockでのNL-to-SQLにおけるトークン上限問題を解決するため、RAGを活用して必要なテーブル定義のみを動的にプロンプトへ注入する手法を解説。Knowledge BasesやAgentsを用いた具体的なAWS実装パターンが学べます。
TIPS

[AWS]Bedrockエージェントのスキーマ設定

Amazon Bedrockで高精度なSQL自動生成を実現するための、スキーマ定義ファイル(JSON)の作成手順を解説。テーブル構造やメタデータ、制約の記述方法からエラー対策まで、AIエージェントのDB理解を深める実践的ノウハウを紹介します。
ツール

OpenSearchとRDBとNoSQLの賢い使い分け

OpenSearch、RDB、MongoDB(NoSQL)の設計思想や得意分野の違いを整理し、用途に応じた最適なデータベース選定基準を解説します。セマンティック検索やデータ整合性、開発効率の観点から、各技術の賢い使い分け方が理解できます。
ツール

[AWS]OpenSearchのベクターDBが変える検索の未来

AWS OpenSearchのVector DBを効果的に活用するための設定定義(次元数やアルゴリズムなど)や、Amazon Bedrockと連携したRAGソリューション構築に必要なデータ投入・運用プロセスを分かりやすく解説します。